Um chip brasileiro
para revolucionar a IA.
Computação analógica de ponta, projetada do zero no Brasil. Um servidor de IA na sua rede privada, muito mais veloz que uma GPU e muito mais barato que a nuvem.
Tecnologia de ponta: a memória é o processador.
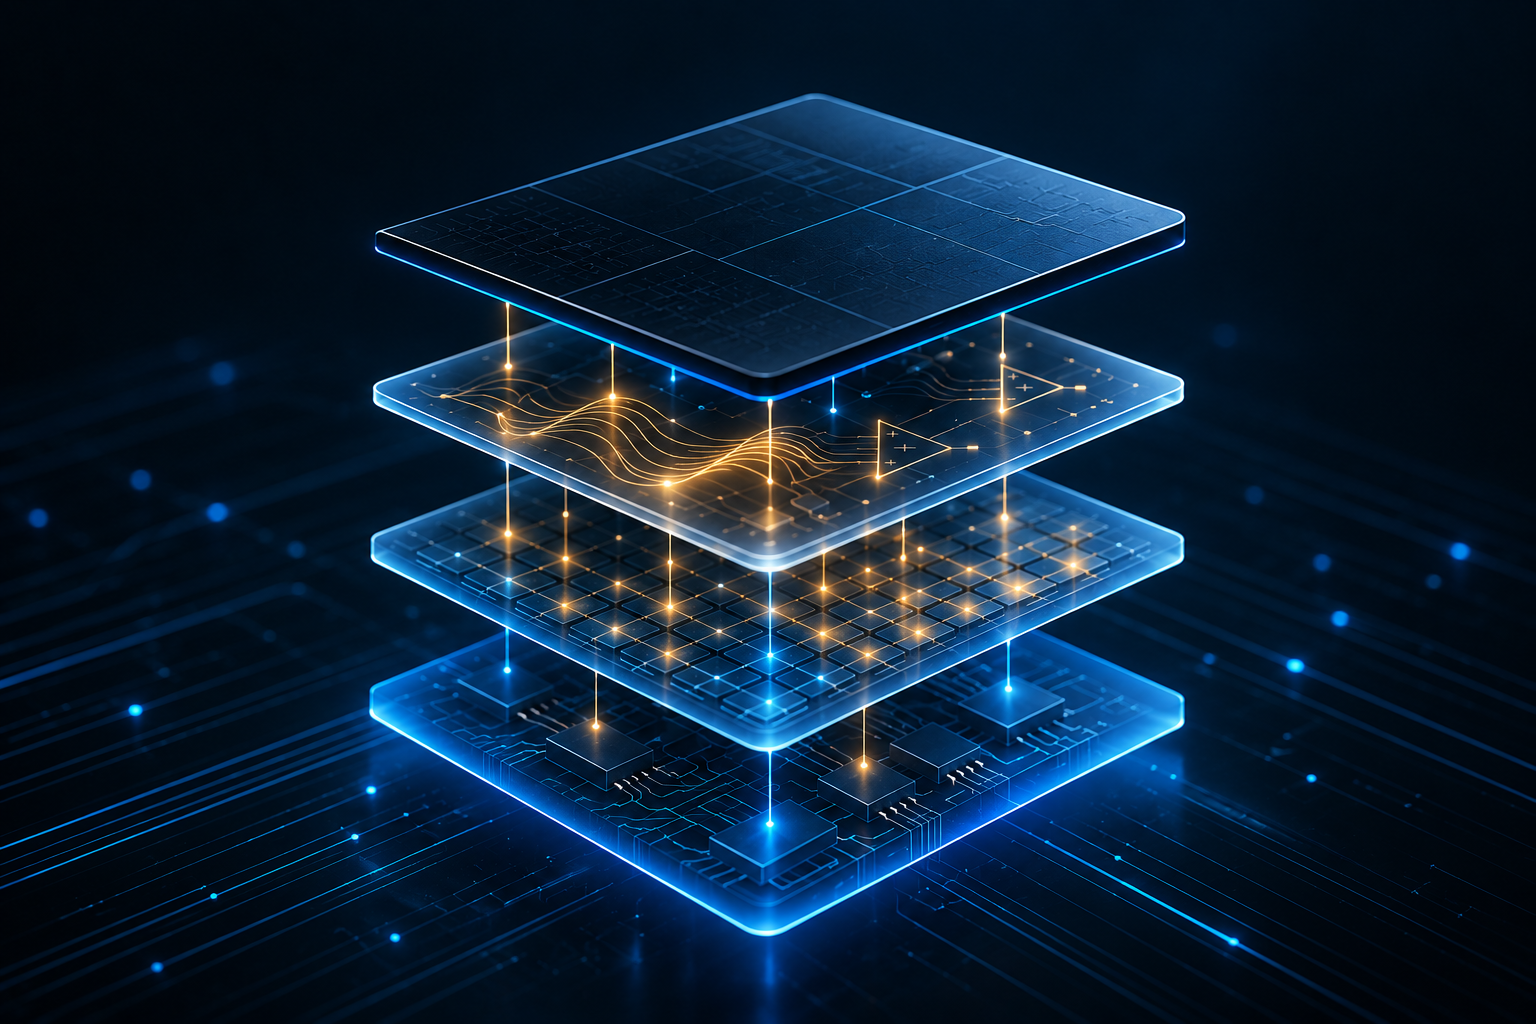
Uma GPU gasta a maior parte do tempo e da energia movendo o modelo entre a memória e o processador. Nosso chip é uma arquitetura nova, desenvolvida no Brasil: o modelo fica parado no silício e a corrente que passa por ele já é a resposta.
Multiplicar é deixar a corrente passar
Cada peso conduz mais ou menos corrente. Entrada vezes peso sai pronto.
Somar é um fio
Milhares de termos se somam no mesmo condutor, sem instrução.
Ler é um instante
A camada inteira vira número de uma vez. Por isso é rápido e gasta pouco.
Feito aqui
Projeto, simulação e validação no Brasil, com processo de fabricação aberto. Primeiro silício em 2027.
Muito mais rápido que uma GPU.
Um modelo de 8 bilhões de parâmetros, um usuário, a mesma pergunta. A GPU responde a ~100 tokens por segundo. O nosso chip, a ~5.000.
GPU de consumo
Lento e gasta muito
50× mais rápido, 23× menos energia
Linear Compute: projeção de engenharia para um modelo de 8B, um usuário, a 25 °C, com base nas medidas da célula no processo real. Serão substituídos pelos números medidos no primeiro silício, em 2027. GPU: valores públicos típicos de uma placa de consumo topo de linha rodando o mesmo modelo quantizado.
Muito mais barato que nuvem.
A nuvem cobra por usuário, todo mês, para sempre. A GPU local custa caro, pesa na conta de luz e perde velocidade conforme mais gente usa. O chip da Linear Compute é um custo só, atende dezenas de pessoas ao mesmo tempo e gasta a energia de uma lâmpada.
IA na nuvem
R$ 150.000/ano
100 pessoas × R$ 125 por mês, sem contar API
- Cobra por usuário, para sempre
- Seus dados saem da empresa
- Depende de internet e de terceiros
GPU local
~R$ 2.700/ano só de energia
350 W ligados o dia inteiro, a R$ 0,90 o kWh
- Dados ficam na empresa
- Hardware caro, esquenta, faz barulho
- Poucos usuários: a velocidade cai conforme mais gente usa
~R$ 120/ano de energia
15 W ligados o dia inteiro. Hardware pago uma vez.
- Dados e prompts nunca saem da rede
- Sem assinatura, sem custo por token
- Dezenas de usuários ao mesmo tempo
Exemplos de conta. Nuvem: assinatura típica de US$ 25 por usuário, a R$ 5 por dólar. Energia: consumo contínuo a R$ 0,90 por kWh. O preço será divulgado com a lista de reserva.
A tecnologia que muda o mercado de IA. Dentro da sua empresa.
Para empresas
Um servidor que atende a demanda de IA inteira da empresa, internamente. Mais rápido e mais barato que qualquer serviço de nuvem, e nenhum dado sai da casa.
- Rápido: ~5.000 tokens por segundo, dezenas de pessoas sem fila
- Barato: custo único, energia de uma lâmpada, zero por token
- Privado: modelo, prompts e documentos ficam na sua rede
- IoT: câmeras, sensores e máquinas da fábrica falando com a IA local, sem internet
Em casa
Seu próprio servidor de IA privado, do tamanho de um SSD externo. Liga na tomada, conecta na rede de casa e responde a 5.000 tokens por segundo.
- Cabe no bolso, gasta 15 W
- Sem assinatura, sem limite de uso
- O que você pergunta fica com você
Quer ser dos primeiros?
Tecnologia brasileira de ponta, primeiro silício em 2027. Estamos montando a lista de empresas e pessoas que vão receber os primeiros chips.
Entrar na lista